VPS тормозит? За 15 минут поймёте: это CPU, диск, RAM или сеть
Медленный сайт, долгий SSH или «зависшая» база на VPS почти всегда сводятся к одному из четырёх узких мест: процессор, память, диск или сеть. Ниже — короткий регламент диагностики на Linux без сторонних панелей. За 10–15 минут можно понять, куда смотреть дальше: тюнить приложение или менять конфигурацию сервера.
Если вы только получили доступ к машине, сначала убедитесь, что вход по SSH стабилен — базовая настройка Ubuntu и firewall и подключение по SSH уже разобраны отдельно. Здесь фокус только на производительности.
1. Зафиксируйте симптомы
Перед командами ответьте себе на три вопроса:
- Тормозит всё (SSH, сайт, БД) или только одно приложение?
- Проблема постоянная или всплесками (по вечерам, при бэкапе, при деплое)?
- После каких действий стало хуже (обновление CMS, рост трафика, новый контейнер)?
Запишите время и что именно «медленно»: TTFB сайта, время SQL-запроса, отклик терминала. Без этого легко лечить не то узкое место.
2. CPU: load average и занятость ядер
Смотрите общую нагрузку:
uptime
nproc
htop
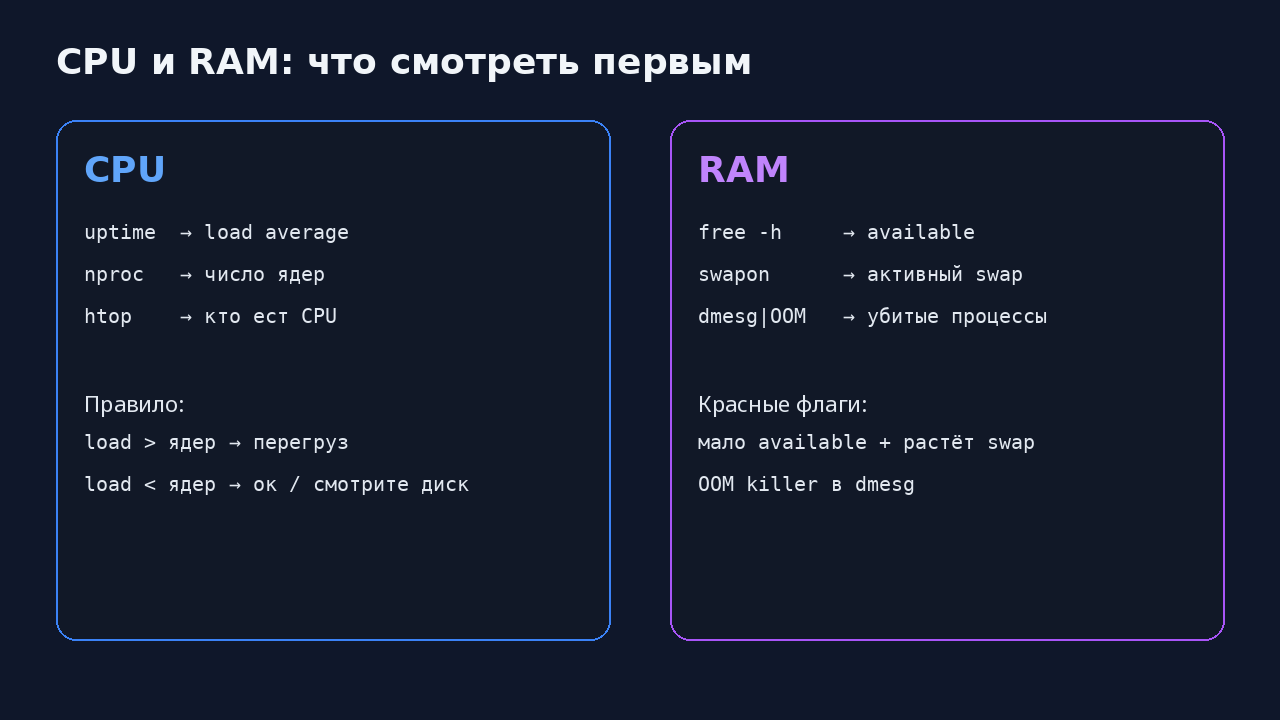
load average сравнивайте с числом ядер (nproc). Если load стабильно выше числа ядер, CPU или очередь на диск забиты. В htop отсортируйте процессы по CPU: один «горячий» PHP/Node/Java-процесс — это прикладная нагрузка; десятки коротких воркеров — часто очередь или крон.
Полезный срез без интерактива:
ps aux --sort=-%cpu | head -n 15Если CPU 90–100% при нормальном диске и сети — узкое место процессор. Для однопоточных CMS и тяжёлого PHP часто помогает более высокая частота ядра; для параллельных воркеров — больше vCPU. Как выбирать платформу под задачу, мы разбирали в гайде по выбору VPS (KVM, Ryzen, NVMe).
3. RAM: память, swap и OOM
free -h
swapon --show
dmesg -T | grep -i -E 'oom|killed process' | tail
Красные флаги:
- мало
available, при этом swap постоянно растёт; - в
dmesgесть OOM killer — процесс убит из‑за нехватки памяти; - сайт «отмирает» волнами, а CPU при этом невысокий.
Не путайте кэш Linux (buff/cache) с утечкой: ядро отдаёт кэш приложениям при необходимости. Смотрите именно available и факты OOM.
Если swap активен постоянно, диск начинает «гореть» (см. следующий блок) — тормоза выглядят как «медленный диск», хотя первопричина нехватка RAM.
4. Диск: iowait и реальный IOPS
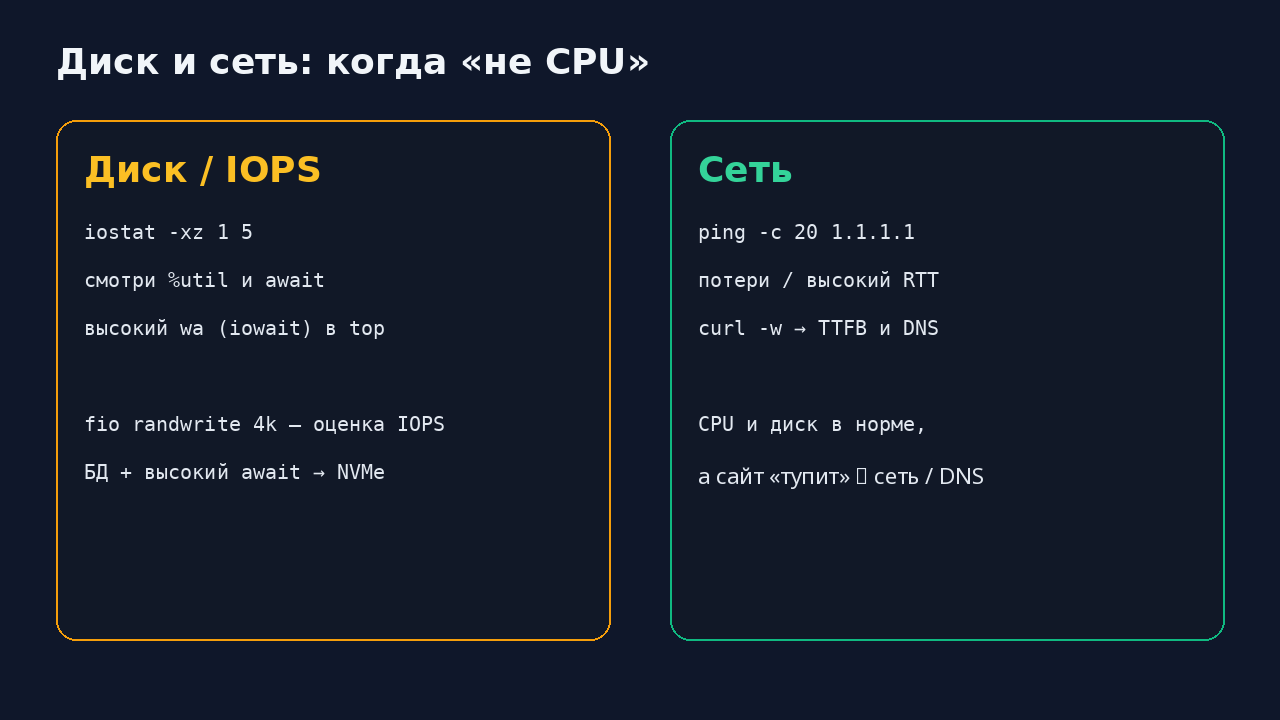
Когда система ждёт диск, в top/htop растёт wa (iowait), а load может быть высоким при среднем %CPU.
iostat -xz 1 5Смотрите %util и await по устройству данных. Если утилита близка к 100%, а await сотни миллисекунд — узкое место накопитель или перегруженный shared-диск.
Быстрая оценка случайной записи (осторожно на проде, лучше на тестовом разделе; размер можно уменьшить):
fio --name=randwrite --ioengine=libaio --iodepth=32 --rw=randwrite --bs=4k --direct=1 --size=256M --numjobs=1 --runtime=20 --group_reportingНизкий IOPS на случайной 4k-записи и высокий iowait на живой БД — типичный сигнал, что нужен более быстрый диск. Для MySQL/PostgreSQL и Bitrix это часто решают NVMe VPS, а не «ещё чуть-чуть CPU».
5. Сеть: это не всегда «тормоза сервера»
Проверьте путь до клиента и до внешних API:
ping -c 20 1.1.1.1
ping -c 20 ваш-домен.пример
curl -o /dev/null -s -w 'DNS %{time_namelookup} TCP %{time_connect} TLS %{time_appconnect} TTFB %{time_starttransfer} total %{time_total}\n' https://ваш-сайт.пример
Потери и высокий RTT бьют по ощущению «сайт тупит», хотя CPU и диск в норме. Отдельно проверьте, не упёрлись ли в лимит трафика или шейпинг у провайдера: после исчерпания квоты скорость может упасть, хотя load average красивый.
Если аудитория в РФ, имеет смысл сверить пинг до Москвы; для EU-сценариев — до площадки в Германии. Обзор локаций и тарифов — на странице аренды VPS.
6. Код или железо?
Краткое правило:
- один процесс жрёт CPU / RAM → сначала профилируйте приложение и кэш;
- высокий iowait при «пустом» CPU → диск или слишком агрессивный swap;
- CPU и диск спокойны, а TTFB большой → сеть, DNS, upstream, геолокация;
- всё растёт пропорционально трафику → либо масштабируйте ресурсы, либо оптимизируйте запросы.
Не меняйте тариф «на глаз» после одной минуты top. Снимите 5–10 минут метрик в момент проблемы, затем решайте.
7. Чек-лист на 15 минут
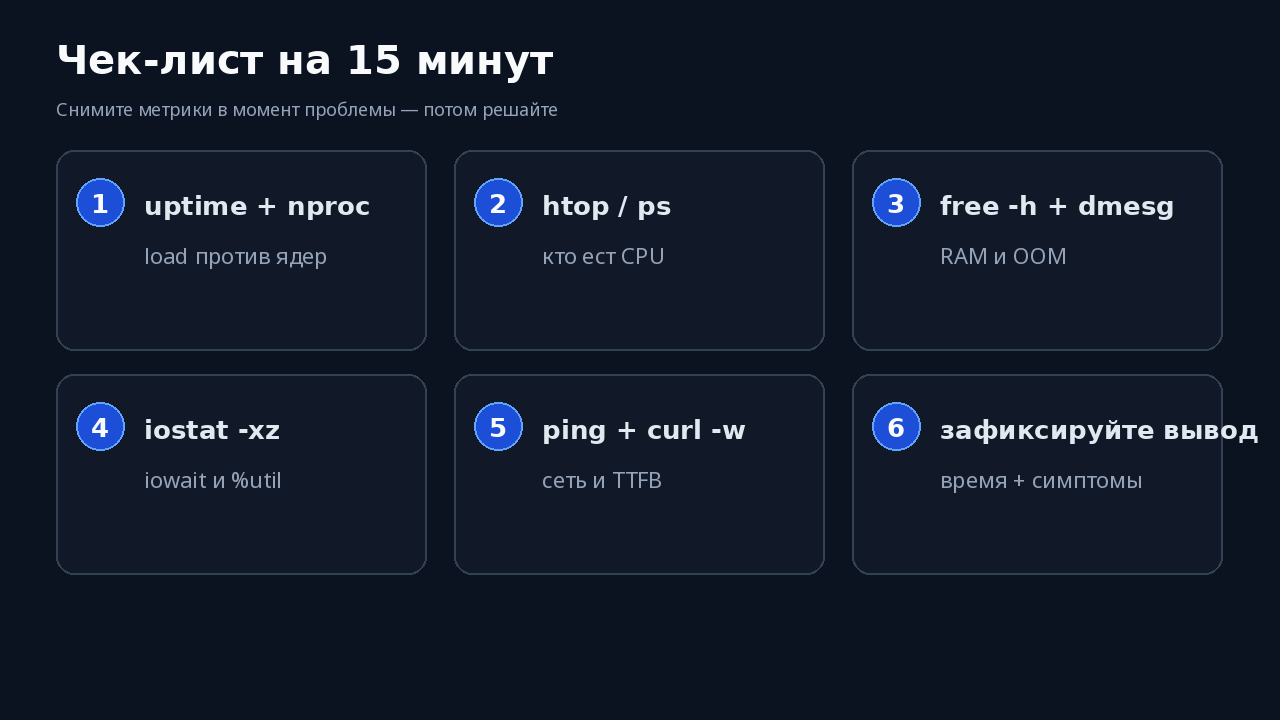
uptime+nproc— load против ядер.htop/ps— кто ест CPU.free -h+ поиск OOM вdmesg.iostat -xz 1 5— iowait и %util.ping+curl -w— сеть и TTFB.- Зафиксируйте вывод и время — пригодится поддержке.
Если после диагностики ясно, что упираетесь в диск или однопоточный CPU, посмотрите актуальные конфигурации на azerta.ru/vps — выдача сервера после оплаты занимает до 120 секунд, можно быстро сравнить NVMe и частотные линейки на практике.
FAQ
Почему VPS тормозит при низком %CPU?
Часто виноват диск (высокий iowait) или ожидание сети. Смотрите iostat и TTFB, а не только столбец CPU.
Что такое load average и когда он «плохой»?
Это длина очереди к ресурсам. Ориентир: сравнивайте с числом ядер. Load 4 на 1 vCPU — перегруз; load 4 на 8 vCPU — обычно нормально.
Swap всегда вреден?
Небольшой swap как страховка допустим. Постоянный активный swap под нагрузкой почти всегда замедляет сервер из‑за диска.
Как понять, что нужен NVMe?
База или диск-очередь: высокий await/%util, медленные случайные 4k в fio, при этом CPU не упирается в 100%.
Можно ли обойтись без смены тарифа?
Да: кэш, индексы БД, лимиты PHP-FPM/воркеров, отключение лишних кронов. Но если диск физически медленный, тюнинг лишь отложит проблему.
Документация
- htop — интерактивный просмотр процессов
- fio — бенчмарк дисков
- iostat (sysstat) — статистика I/O