Бэкап есть. А восстановить пробовали?
Бэкап есть. А восстановить пробовали?
Резервная копия на VPS бесполезна, пока вы хотя бы раз не восстановили её на чистый диск или в тестовую папку. Ниже — рабочая схема: что копировать, как делать бэкап через rsync и restic, и как проверить восстановление без сюрпризов в день аварии.
Статья не про «какой тариф купить», а про практику. Базовую настройку Ubuntu и firewall считаем уже сделанной. Если диск на проде уже забит и бэкапы некуда складывать — сначала разберитесь с местом в статье про df на 100%, потом возвращайтесь сюда.
Зачем вообще проверять восстановление
Большинство «бэкапов» на небольших VPS выглядят так: cron раз в сутки гоняет rsync или скрипт с mysqldump, письмо об успехе никто не читает, а в день аварии выясняется, что:
- копировался только
/var/www, а база лежала в/var/lib/mysqlи в дамп не попала; - пароль от restic-репозитория жил в том же
.env, который умер вместе с диском; --deleteв rsync когда-то снёс нужные файлы на бэкап-хосте, потому что на проде их уже не было;- снапшот в панели есть, но он с той же машины и того же диска — при аппаратном сбое или ошибке в панели он недоступен.
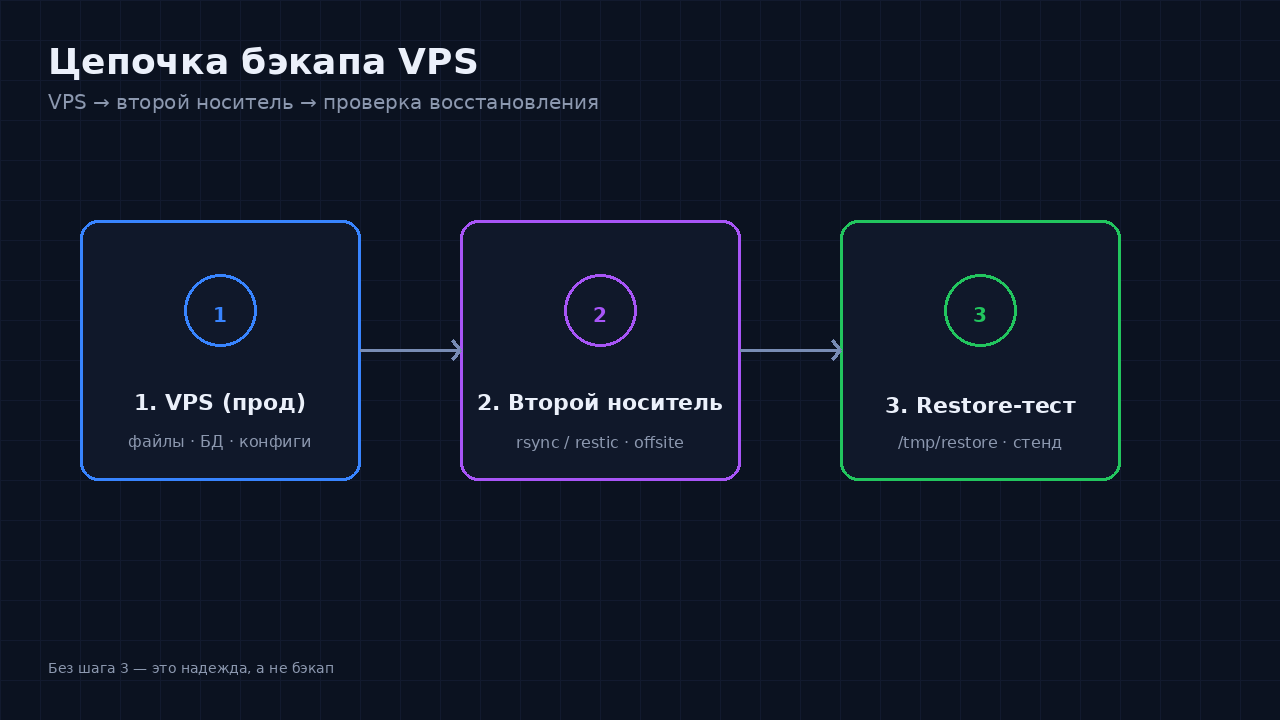
Проверка восстановления — это не паранойя. Это единственный способ узнать, что цепочка реально работает. Без неё у вас не бэкап, а надежда.
Что обязательно входит в бэкап
Минимум для сайта или сервиса на VPS:
- файлы приложения и загрузок пользователей (
/var/www,uploads, media); - дамп базы данных (или снимок volume у Docker);
- конфиги (
nginx, systemd unit-ы,.envвне git — осторожно с секретами); - список cron (
crontab -l) иdocker-compose.yml/ compose-стек, если используете; - TLS-ключи и сертификаты, если не перевыпускаете их заново при восстановлении (для Let’s Encrypt чаще проще выпустить снова — см. статью про SSL).
Не храните единственную копию на том же диске, который может умереть. Второй носитель: другой VPS, object storage (S3-совместимый), домашний NAS по SSH. Правило «3-2-1» в упрощённом виде для маленького проекта: минимум две копии на разных носителях, одна — вне той же площадки.
Перед тем как писать скрипты, составьте короткий список путей на бумаге или в Wiki. Без списка через полгода никто не вспомнит, что .env лежал в /opt/app/secrets, а не рядом с кодом.
rsync: простой инкрементальный бэкап файлов
rsync хорош, когда нужна понятная зеркальная копия каталога: сайт, uploads, конфиги. Он копирует только изменившиеся файлы, сохраняет права и симлинки (с правильными флагами) и не требует отдельного «репозитория».
Пример ежедневной синхронизации каталога сайта на удалённый хост:
rsync -aHAX --delete \
  --exclude '.git' \
  --exclude 'node_modules' \
  --exclude 'vendor/cache' \
  /var/www/app/ \
  backup@backup-host:/backups/app/
Что значат флаги:
-a— архивный режим (рекурсия, права, времена);-H— жёсткие ссылки;-A/-X— ACL и xattr, если ими пользуетесь;--delete— на приёмнике удаляется то, чего уже нет на источнике (зеркало).
--delete опасен без dry-run: если на проде случайно очистили uploads, зеркало тоже очистится. Для критичных данных иногда делают «версионные» каталоги по дате вместо чистого зеркала, либо комбинируют rsync с restic.
Перед cron сделайте ручной прогон и посмотрите, что изменилось:
rsync -aHAX --delete -n --itemize-changes \
  /var/www/app/ backup@backup-host:/backups/app/ | head -n 50
Флаг -n — dry-run: ничего не пишет, только показывает план. Прогоняйте его после смены структуры каталогов и после крупных деплоев.
SSH-ключ для пользователя backup лучше отдельный, с ограничением по команде (command= в authorized_keys) или хотя бы без sudo на бэкап-хосте. Каталог /backups не должен быть доступен извне по HTTP.
Дамп базы отдельно от файлов
Файлы MySQL/PostgreSQL «на горячую» через rsync — плохая идея: копия может оказаться неконсистентной. Делайте логический дамп.
MySQL / MariaDB:
mysqldump --single-transaction --routines --triggers app_db \
  | gzip > /tmp/app_db.sql.gz
scp /tmp/app_db.sql.gz backup@backup-host:/backups/db/app_db-$(date +%F).sql.gz
rm -f /tmp/app_db.sql.gz
PostgreSQL:
sudo -u postgres pg_dump -Fc app_db > /tmp/app_db.dump
scp /tmp/app_db.dump backup@backup-host:/backups/db/app_db-$(date +%F).dump
rm -f /tmp/app_db.dump
Дамп не оставляйте в web-root и в /tmp дольше, чем нужно для копирования. Для Docker-стека дамп обычно берут из контейнера:
docker compose exec -T db mysqldump -u root -p"$MYSQL_ROOT_PASSWORD" app_db \
  | gzip > /tmp/app_db.sql.gz
Имя файла с датой удобно для ротации: старые дампы потом чистите скриптом find ... -mtime +14 -delete на бэкап-хосте — не на проде.
restic: снимки с шифрованием и проверкой
restic удобен, когда нужны версии во времени, дедупликация и проверка целостности репозитория. Он шифрует данные паролем репозитория: даже если кто-то получит доступ к бэкап-хранилищу, без пароля снимки бесполезны.
Установка на Ubuntu:
sudo apt update
sudo apt install -y restic
Инициализация репозитория (один раз):
export RESTIC_REPOSITORY=sftp:backup@backup-host:/restic-repo
export RESTIC_PASSWORD_FILE=/root/.restic-pass
chmod 600 /root/.restic-pass
restic init
Пароль репозитория храните вне бэкапа приложения: в менеджере паролей, в сейфе, на отдельном носителе. Если пароль живёт только на том же VPS — при потере диска вы потеряете и данные, и ключ к ним.
Ежедневный бэкап и быстрая проверка:
restic backup /var/www/app /etc/nginx /etc/systemd/system
restic check
restic snapshots
Раз в неделю имеет смысл более тяжёлая проверка кусков данных:
restic check --read-data-subset=10%Она дольше, но ловит битые блоки на диске бэкап-хоста. Полный --read-data — ещё надёжнее, но на больших репозиториях запускайте его редко и в окне обслуживания.
Ротация снимков через политику forget:
restic forget --keep-daily 14 --keep-weekly 4 --keep-monthly 3 --pruneСначала forget помечает лишнее, prune реально освобождает место. Без prune репозиторий будет расти даже после «удалённых» снимков.
restic отлично сочетается с отдельным дампом БД: положите свежий .sql.gz в /var/backups/db/ и включите этот каталог в restic backup. Так и файлы, и база попадут в один снимок по времени.
Главный шаг: восстановление на стенде
Выделите тестовый каталог или второй VPS и прогоните сценарий. Не восстанавливайте поверх прода «на всякий случай проверить» — один неверный путь, и вы затрёте живые данные.
- Восстановите файлы в
/tmp/restore-test(не поверх прода). - Поднимите БД из дампа на тестовом инстансе или в отдельной схеме.
- Откройте сайт через временный
hostsили тестовый домен. - Проверьте логин, формы, загрузки, оплату/webhook если есть.
- Запишите время восстановления и список граблей — это станет runbook на аварию.
Восстановление из rsync-зеркала:
mkdir -p /tmp/restore-test
rsync -aHAX backup@backup-host:/backups/app/ /tmp/restore-test/
Восстановление из restic:
mkdir -p /tmp/restore-test
restic restore latest --target /tmp/restore-test
# или конкретный снимок:
# restic snapshots
# restic restore a1b2c3d4 --target /tmp/restore-test
Пример распаковки дампа MySQL в тестовую БД:
mysql -e 'CREATE DATABASE app_restore_test'
gunzip -c app_db.sql.gz | mysql app_restore_test
mysql -e 'SHOW TABLES FROM app_restore_test' | head
Для PostgreSQL из custom-format:
sudo -u postgres createdb app_restore_test
sudo -u postgres pg_restore -d app_restore_test /tmp/app_db.dump
После восстановления приложения поправьте .env на тестовые доступы к БД и не включайте боевые webhook/почту — иначе тестовый стенд начнёт слать письма клиентам.
Если восстановление не запускали ни разу — у вас не бэкап, а надежда. Календарный минимум: раз в месяц полный прогон; после смены схемы БД или крупного рефакторинга путей — внепланово.
Расписание, cron и алерты
Практичный минимум для небольшого сайта:
- файлы: ежедневно инкремент (rsync или restic);
- БД: ежедневно + перед крупным деплоем;
- хранить 7–14 дневных точек и 2–4 недельных;
- алерт, если job не завершился (письмо, Telegram-бот, healthcheck URL).
Пример cron на проде (корень или отдельный пользователь с нужными правами):
15 3 * * * /usr/local/bin/backup-app.sh >> /var/log/backup-app.log 2>&1Внутри скрипта — дамп, rsync/restic, проверка кода возврата и вызов webhook при ошибке. Не глотайте stderr: если mysqldump упал из‑за прав, а rsync «успешно» уехал пустой каталог, вы об этом не узнаете.
Следите за местом на диске бэкап-хоста: забитый том молча ломает цепочку. Раз в неделю на бэкап-машине:
df -h /backups
du -sh /backups/* /restic-repo 2>/dev/null
Если бэкап-хост тоже VPS, не ставьте его в ту же локацию «для удобства» без второй копии: пожар в одном ЦОД или ошибка биллинга может задеть оба. Москва и Франкфурт (Германия) в каталоге VPS как раз дают географический разнос без лишней сложности.
Типичные ошибки
Бэкап на тот же диск. Снапшот раздела или папка /backup на том же NVMe не спасает от смерти диска и от rm -rf по ошибке.
Секреты в открытом виде в зеркале. .env, ключи SSH, дампы с PII лучше шифровать (restic делает это сам) или хотя бы ограничивать доступ на приёмнике.
Нет dry-run после смены путей. Переехали с /var/www/html на /var/www/app — старый cron продолжает зеркалить пустой каталог.
Восстановление «в уме». Пока вы не подняли сайт из бэкапа руками, вы не знаете, сколько это займёт и чего не хватает в списке путей.
Игнор кода возврата в cron. Добавьте set -euo pipefail в скрипт и проверку $? после каждого критичного шага.
Чек-лист
- Список того, что копируем (файлы + БД + конфиги + cron/compose).
- Копия не на том же единственном диске; понятно, где лежит пароль restic.
- Dry-run /
restic checkбез ошибок. - Успешное восстановление на стенде за последние 30 дней с записанным временем.
- Алерт на падение job и мониторинг места на бэкап-хосте.
- Понятно, кто чинит прод, если ночью упало, и где лежит runbook.
Когда место или IOPS на проде упираются в потолок, сравните NVMe VPS и каталог VPS — выдача до 120 секунд после оплаты. Для тестового стенда восстановления часто хватает небольшого тарифа с посуточной оплатой: подняли, проверили, выключили.
FAQ
Достаточно ли снапшота в панели? Снапшот удобен для быстрого отката после неудачного обновления на той же машине. Он не заменяет бэкап приложения на другой носитель и не заменяет проверку восстановления. При проблемах с диском или аккаунтом снапшот может быть недоступен.
Можно ли бэкапить только файлы без БД? Для статического сайта — да. Для динамического (CMS, личный кабинет, заказы) — нет: без дампа вы получите «красивую оболочку» без данных пользователей.
Куда не класть .env? Не в публичный репозиторий, не в web-root, не в чаты и тикеты без шифрования. В restic-репозиторий — можно, если пароль репозитория хранится отдельно и доступ к хранилищу ограничен.
Как часто проверять восстановление? Раз в месяц минимум; после смены схемы БД, смены путей приложения или смены бэкап-хоста — обязательно. Фиксируйте дату последней успешной проверки рядом с cron.
rsync или restic — что выбрать? Для простого зеркала файлов и понятного «лежит копия каталога» — rsync. Для версий, шифрования и check целостности — restic. Часто оба: rsync/дамп на промежуточный хост или restic сразу в шифрованный репозиторий.
Нужен ли отдельный VPS под бэкапы? Не обязателен, но удобен: дешёвый второй сервер в другой локации + object storage как третья копия. Главное — не тот же единственный диск, что у прода.