df говорит 100%. Кто съел место — логи, Docker или journal?
df говорит 100%. Кто съел место — логи, Docker или journal?
Когда df -h показывает корневой раздел на 100%, падают обновления, Docker, почта и даже SSH-сессии с записью. Это не то же самое, что «VPS тормозит из‑за iowait» — здесь проблема ёмкости. Ниже — быстрый поиск виновника: логи, journald, Docker, кэши и забытые дампы, плюс профилактика, чтобы диск снова не забился за неделю.
Диагностику CPU/диска по скорости мы разбирали в статье «VPS тормозит…». Сейчас — только место на диске. Бэкапы при забитом разделе тоже страдают: если нет куда писать дамп, проверка восстановления уже не спасёт — сначала освободите гигабайты.
Что ломается при 100%
Короткий список симптомов, по которым узнают «диск кончился», ещё до df:
apt upgradeпадает с «No space left on device»;- Nginx/PHP пишут в error.log про невозможность создать временный файл;
- Docker не стартует контейнеры, MySQL уходит в read-only;
- cron-бэкап «успешен» в письме, а файл дампа нулевого размера;
journalctlсам перестаёт писать, и вы теряете следы инцидента.
Чем раньше поймаете порог 85–90%, тем меньше шанс чинить прод ночью. Дальше — пошаговый разбор.
Шаг 1. Где именно конец места
df -h
df -i
Смотрите и inode (df -i): раздел может быть «полным» при видимых свободных гигабайтах, если накопились миллионы мелких файлов (сессии PHP, кэш, mail queue, thumbnail’ы). Запишите, какой mount заполнен: /, /var, отдельный том под Docker — дальше du гоняйте именно по нему.
Пример чтения вывода:
/dev/sda1на/— 100% → копаем корень;- отдельный
/var/lib/docker— 98% → чистка Docker не поможет корню и наоборот; Use%по inode 100%, по блокам 40% → ищем рой мелких файлов, а не «большой лог».
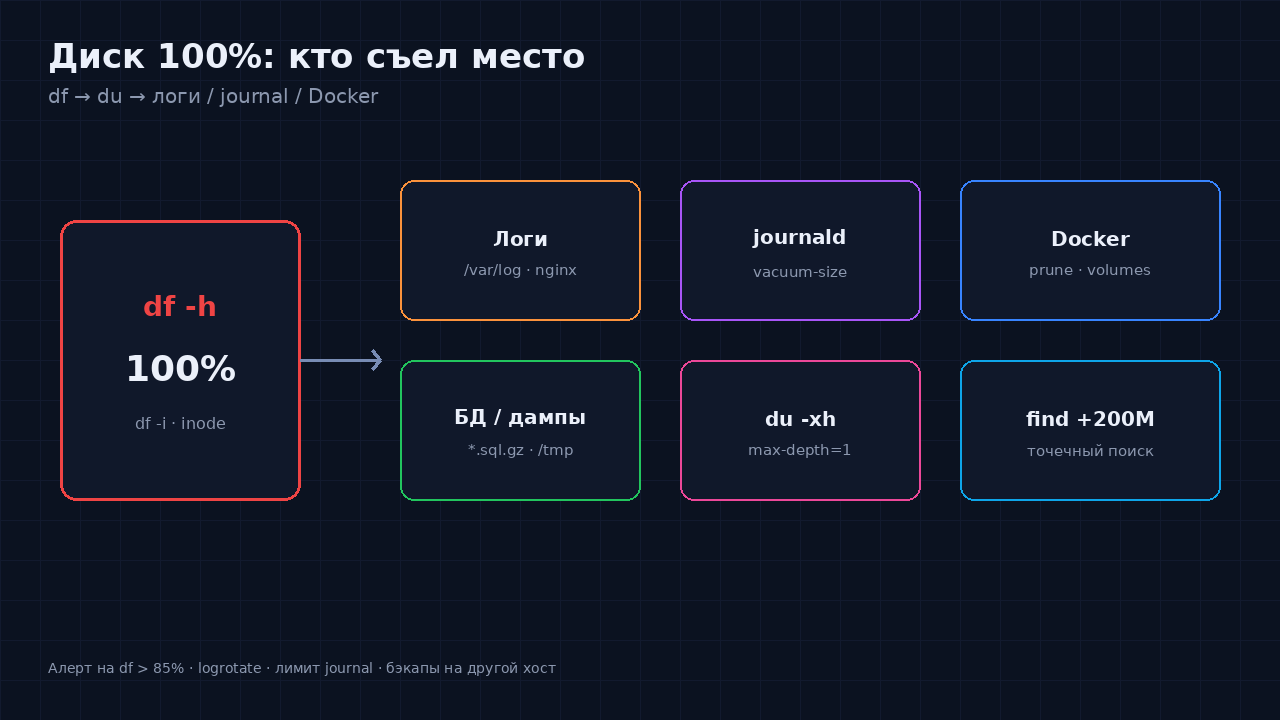
Быстрая сводка без лишнего шума:
df -hT | grep -v tmpfs
df -i | grep -v tmpfs
Шаг 2. Кто занимает каталоги
sudo du -xh / --max-depth=1 2>/dev/null | sort -h
sudo du -xh /var /home /usr /tmp --max-depth=1 2>/dev/null | sort -h
Частые «пожиратели» на VPS:
/var/log— access/error логи nginx, приложений;/var/lib/docker— образы, volume, build cache;/var/log/journalили systemd journal;/var/lib/mysql//var/lib/postgresql— данные БД (это уже не «почистить prune», а рост данных);- старые бэкапы и
*.sql.gzв/rootили/tmp; /var/cache/aptпосле серии обновлений безautoclean.
Уточнение внутри /var:
sudo du -xh /var --max-depth=2 2>/dev/null | sort -h | tail -n 30Флаг -x не уходит на другие файловые системы — удобно, если /var или Docker на отдельном диске. Без -x du может «уйти» на сетевой mount или bind и запутать картину.
Если подозреваете inode, а не гигабайты:
sudo find /var -xdev -type d -print0 2>/dev/null \
  | while IFS= read -r -d '' d; do
      echo "$(find "$d" -xdev -maxdepth 1 -type f 2>/dev/null | wc -l) $d"
    done | sort -n | tail -n 20
Грубо, но быстро показывает каталоги с кучей файлов на одном уровне (сессии, очереди, кэш картинок).
Шаг 3. journald
journalctl --disk-usage
sudo journalctl --vacuum-size=200M
# или
sudo journalctl --vacuum-time=7d
Ограничьте рост постоянно в /etc/systemd/journald.conf (раскомментируйте и задайте):
[Journal]
SystemMaxUse=200M
SystemKeepFree=500M
MaxRetentionSec=14day
Затем:
sudo systemctl restart systemd-journald
journalctl --disk-usage
Для расследования инцидента сначала сохраните нужный кусок, потом уже vacuum:
journalctl --since '2026-09-20' --until '2026-09-21' > /root/incident.log
# только после копирования:
sudo journalctl --vacuum-size=200M
Не кладите incident.log обратно в /var/log без ротации — иначе через неделю сами себе устроите повтор. После разбора перенесите файл на бэкап-хост или удалите.
Шаг 4. Docker без жалости к кэшу — но с головой
docker system df
docker system prune -a --volumes
--volumes удалит неиспользуемые volume — убедитесь, что там нет нужных данных. Часто после серии CI/CD на VPS остаются десятки гигабайт висячих образов и build cache.
Более осторожный порядок:
docker builder prune -f
docker image prune -a -f
docker container prune -f
docker volume ls
# volumes — только после проверки, что том не нужен:
# docker volume prune -f
Перед агрессивной очисткой имеет смысл глянуть, что занимает место внутри Docker:
docker system df -v | head -n 80
sudo du -xh /var/lib/docker --max-depth=1 2>/dev/null | sort -h
Если Docker лежит на отдельном томе, смотрите df -h именно по этому mount — очистка / не поможет. И наоборот: полный корень при пустом томе Docker лечится логами и journal, а не prune.
Отдельная ловушка — build на проде. Если CI собирает образы прямо на боевом VPS, заведите лимит и регулярный docker builder prune. Лучше собирать на отдельной машине и пушить в registry.
Шаг 5. Логи приложений и logrotate
Nginx/Apache access-логи на загруженном сайте раздуваются за дни. Включите logrotate, проверьте /etc/logrotate.d/. Временная мера на горящем диске:
sudo truncate -s 0 /var/log/nginx/access.log
sudo truncate -s 0 /var/log/nginx/error.log
truncate обнуляет файл, не меняя inode — процесс, который держит лог открытым, продолжает писать в тот же файл, и место освобождается сразу. Это лучше, чем rm: после rm процесс может продолжать писать в удалённый inode, и df не отпустит гигабайты, пока сервис не перезапустите.
Проверка «удалён, но открыт»:
sudo lsof +L1 2>/dev/null | head
# или
sudo lsof 2>/dev/null | grep deleted | head
Лучше ротация, чем ручной truncate на постоянке. Пример фрагмента для nginx (обычно уже есть пакетный файл — проверьте, что он не отключён):
sudo cat /etc/logrotate.d/nginx
sudo logrotate -d /etc/logrotate.d/nginx   # dry-run
sudo logrotate -f /etc/logrotate.d/nginx   # принудительно
Для приложений в /var/www и PM2/systemd проверьте собственные log-файлы: иногда ротируется только nginx, а Node/PHP пишет гигабайты рядом (storage/logs, .pm2/logs, ~/.npm/_logs). Для systemd unit можно ограничить размер через StandardOutput=append:... и внешний rotate или журналировать в journald с лимитом из шага 3.
Apt-кэш после обновлений:
sudo apt-get clean
sudo apt-get autoclean
du -sh /var/cache/apt
Шаг 6. Большие файлы точечно
sudo find /var -xdev -type f -size +200M -printf '%s %p\n' 2>/dev/null | sort -n | tail
sudo find /root /tmp /home -xdev -type f -size +100M -printf '%s %p\n' 2>/dev/null | sort -n | tail
Ищите забытые дампы БД, ядра (core), старые node_modules в /tmp, архивы деплоя, *.sql.gz месячной давности. Перед удалением убедитесь, что файл не нужен для отката — и что копия уже есть на другом носителе.
Подозрительные имена:
/root/backup.sql,/tmp/dump.sql.gz;core,core.*в домашних и/var/crash;- старые релизы в
/var/www/releasesбез очистки; *.tar.gzдеплоя по 500M+ в/home.
Если нашли огромный дамп и он единственный — сначала скопируйте на бэкап-хост, потом удаляйте с прода. Иначе «освободили диск» ценой потери единственной копии.
Профилактика
- алерт на
df> 85% (и отдельно на inode > 85%); logrotateдля веб и приложений, проверка раз в квартал;- лимит journald в
journald.conf; - периодический
docker system dfв cron с письмом, если reclaimable > N гигабайт; - бэкапы — на другой диск/хост (см. статью про бэкапы и проверку восстановления);
- не собирать Docker-образы на том же маленьком проде без ротации кэша.
Простейший cron-мониторинг места:
#!/bin/bash
# /usr/local/bin/check-disk.sh
THRESH=85
USE=$(df -P / | awk 'NR==2 {gsub(/%/,""); print $5}')
if [ "$USE" -ge "$THRESH" ]; then
  echo "Disk / at ${USE}% on $(hostname)" | mail -s "VPS disk alert" you@example.com
  # или curl в Telegram bot API
fi0 * * * * /usr/local/bin/check-disk.shЕсли раздел систематически мал под ваши данные и логи, сравните тарифы с большим NVMe на azerta.ru/vps/nvme или общий каталог VPS. Выдача до 120 секунд после оплаты; для временного «увеличить и переехать» удобна посуточная оплата на время миграции.
Связка с «тормозами»
Забитый диск часто маскируется под медленный сайт: растёт iowait, пишутся ошибки БД, перестают ротироваться логи. Сначала освободите место и убедитесь, что сервисы снова пишут на диск, затем уже гоняйте чек-лист из статьи про диагностику тормозов VPS.
Отдельно проверьте, не включился ли read-only режим из‑за ошибок ФС:
mount | grep ' / '
dmesg -T | grep -i -E 'readonly|i/o error|ext4' | tail
Если после очистки снова упираетесь в объём за недели — это сигнал увеличить диск или вынести логи/бэкапы наружу, а не бесконечно делать prune. Prune лечит симптом накопленного мусора; рост media-библиотеки и БД лечится ёмкостью и архитектурой хранения.
Чек-лист за 20 минут
df -hиdf -i— какой mount и чего не хватает (блоки или inode).du -xh / --max-depth=1— верхний уровень виновников.- journal vacuum + лимит в
journald.conf. docker system df→ осмысленный prune (volumes — только осознанно).- logrotate / truncate больших access-логов; проверить
lsofна deleted. findпо файлам >200M, удалить только осознанно.- Алерт на 85% и план: куда растут данные дальше (БД, media, логи, Docker).
FAQ
Почему df полный, а du меньше? Удалённые, но открытые файлы; или другой mount point. Смотрите sudo lsof +L1 / lsof | grep deleted и отдельно каждый mount. Ещё вариант — файлы в bind-mount или под overlay, куда du без -x зашёл иначе, чем вы ожидали.
Безопасно ли vacuum journal? Да, вы теряете старые логи. Для расследования инцидентов сначала скопируйте нужный кусок на другой диск. Лимит в journald.conf безопаснее регулярного ручного vacuum «на глаз».
Docker prune удалит контейнеры? docker container prune удаляет только остановленные. docker system prune -a снимет неиспользуемые образы — работающие контейнеры останутся, но «лишние» теги уйдут. --volumes опаснее: читайте вывод docker volume ls и документацию до ввода -f.
Закончились inode — что делать? Ищите каталоги с миллионами мелких файлов (кэши, сессии, mail queue) через подсчёт файлов, чистите или выносите на другой раздел. Увеличение диска по блокам без смены ФС inode само не добавит магически — иногда нужен новый раздел с другими параметрами или другая схема хранения сессий (Redis вместо файлов).
Можно ли расширить диск без переезда? Зависит от панели и типа диска. Часто проще заказать больший NVMe и перенести данные по плану миграции, чем жить на вечном prune. Сверьте NVMe VPS и обычный каталог под ваш объём данных и логов.
Нужно ли трогать данные MySQL/PostgreSQL при 100%? Не удаляйте «старые таблицы на глаз». Сначала логи, journal, Docker, дампы в /tmp. Рост БД — отдельная задача: архивация, партиции, вынос cold-данных, увеличение диска.