Георезерв VPS: Москва + Франкфурт — схема бэкапа и переключения при аварии
Один сервер с ежедневным бэкапом закрывает большинство бытовых аварий: кривой деплой, удалённую таблицу, забитый диск. Но если копия лежит в том же датацентре, что и прод, она уязвима к тем же проблемам: падению площадки, сетевому инциденту у провайдера, ошибке на уровне инфраструктуры. Георезерв решает именно эту задачу. Данные и, при желании, тёплая копия сервиса живут в двух разных локациях, например в Москве и во Франкфурте.
Это не замена базовой статьи про бэкап на VPS через rsync и restic. Там разобрано, что копировать и как проверять восстановление на одном сервере. Здесь речь о политике для двух ДЦ: что и как часто гонять между площадками, как переключаться через DNS и где нужна осторожность с персональными данными.
Зачем две локации
Вторая локация нужна не «для галочки». Она закрывает три сценария, против которых бэкап в соседней папке бессилен:
- Недоступна площадка целиком. Проблемы с питанием, магистралью, маршрутизацией. Ваш VPS может быть вообще ни при чём, просто до него никто не доходит.
- Сетевые ограничения и деградация маршрутов. Бывает, что часть аудитории внезапно плохо видит одну из локаций. Вторая площадка с другой связностью даёт запасной путь.
- Ошибка, которая убила и прод, и локальную копию. Скомпрометированный root,
rm -rfпо неверному пути, шифровальщик. Если бэкап-репозиторий доступен с прода на запись и удаление, он погибнет вместе с продом. Удалённая площадка с отдельными ключами и правами append-only — уже настоящая страховка.
Связка «Москва + Франкфурт» удобна тем, что это две независимые инфраструктуры с разной географией и связностью, а задержка между ними обычно умеренная, так что гонять инкрементальные бэкапы раз в час вполне реально.
RPO/RTO простыми словами
Прежде чем что-то настраивать, договоритесь с бизнесом (или с собой) о двух числах.
RPO (Recovery Point Objective) — сколько данных вы готовы потерять. Если бэкап базы уезжает во Франкфурт раз в сутки, RPO равен 24 часам: в худшем случае пропадут все заказы за день. Раз в час — до часа. Потоковая репликация базы — секунды или минуты.
RTO (Recovery Time Objective) — как долго сервис может лежать. «Холодный» резерв (только бэкапы, сервер поднимаем с нуля) — это часы. «Тёплый» резерв (во Франкфурте уже стоит VPS с софтом, нужно только залить свежие данные и переключить DNS) — десятки минут. «Горячий» (реплика базы, приложение запущено) — минуты, ограниченные в основном TTL записи в DNS.
Типичная ловушка: хотят RPO в минуты, а бюджет и время на поддержку как у холодного резерва. Честно запишите целевые цифры в README проекта. Это сразу ответит на вопрос, какая из схем ниже вам нужна.
Что копировать между ДЦ
Между локациями нужно гонять не «всё подряд», а то, без чего сервис не поднять на чистой машине:
- Дампы баз данных (
pg_dump,mysqldump) или WAL/binlog, если нужна реплика. Копировать «живой»/var/lib/postgresqlчерез rsync без остановки базы — плохая идея. - Пользовательские файлы: загрузки, медиа, вложения.
- Конфигурацию:
/etc/nginx, unit-файлы systemd,docker-compose.yml, crontab, конфиги приложения. В идеале всё это уже лежит в git, а во второй ДЦ уезжают только секреты в зашифрованном виде. - Секреты и сертификаты — отдельно и зашифрованно. Пароль от restic-репозитория не должен лежать только на проде.
- Инструкцию по восстановлению. Звучит смешно, но runbook в markdown, доступный, когда прод мёртв, экономит больше времени, чем любая автоматизация.
Не копируйте кэши, node_modules, логи старше нужного срока и docker-образы, которые и так собираются из registry. Они раздувают трафик и время синхронизации.
Схема МСК→FRA (и обратно)
Базовая схема для небольшого проекта выглядит так:
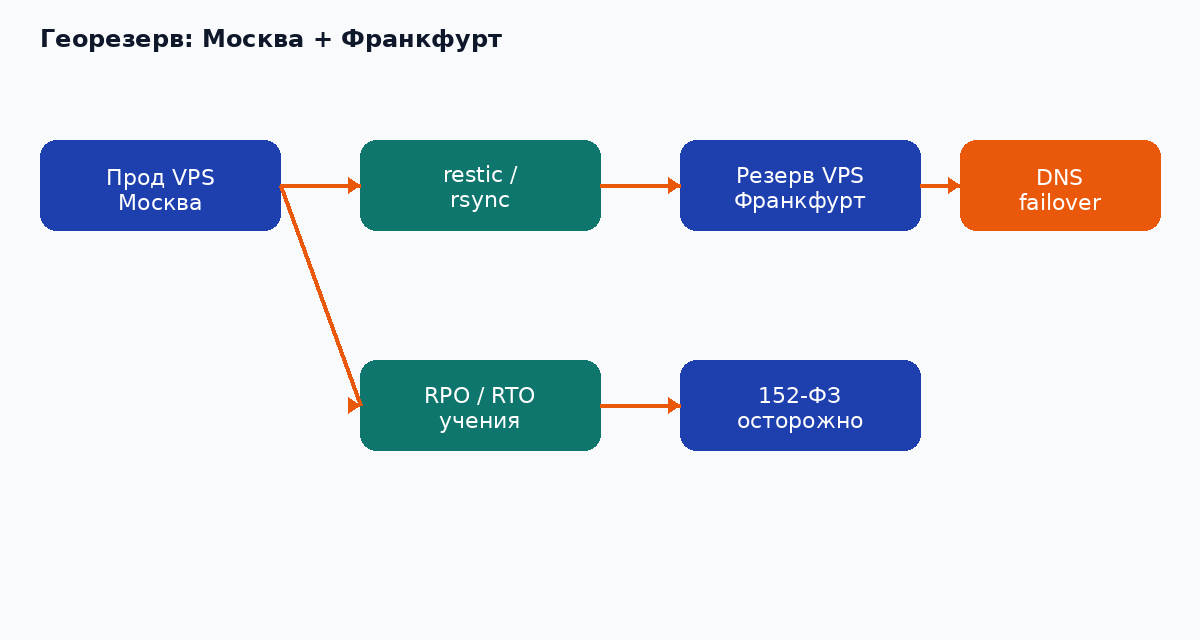
- Основной VPS в Москве обслуживает трафик. Ночью и раз в час делаются дампы базы, restic отправляет инкрементальный снапшот в репозиторий на VPS во Франкфурте.
- Резервный VPS во Франкфурте хранит репозиторий и, в тёплом варианте, держит установленный стек (nginx, рантайм приложения, СУБД), но без пользовательского трафика.
- DNS с умеренным TTL указывает на Москву. При аварии запись переключается на Франкфурт.
- Мониторинг с внешней точки проверяет обе площадки, а не только основную.
«И обратно» — та часть, которую забывают. После аварии прод несколько часов или дней живёт во Франкфурте, туда пишутся новые данные. Возвращаться в Москву нужно по той же процедуре, только в обратном направлении: свежий бэкап FRA→МСК, проверка, переключение DNS. Поэтому скрипты лучше сразу писать симметричными: источник и приёмник задаются переменными, а не захардкожены.
Если для части пользователей данные обязаны оставаться в России (об этом ниже), схема меняется: основной и резервный контуры с персональными данными держите в РФ, а во Франкфурт уезжает только то, что юридически допустимо.
restic/rsync между локациями
Для межДЦ-копий удобнее всего restic поверх SFTP: шифрование на стороне клиента, дедупликация, снапшоты. Во Франкфурте заводим отдельного пользователя без shell:
# на VPS во Франкфурте
adduser --disabled-password --gecos "" backup
mkdir -p /srv/restic && chown backup:backup /srv/restic
В ~backup/.ssh/authorized_keys ключ с ограничениями, чтобы с прода нельзя было ни зайти в shell, ни прокинуть порты:
restrict,command="internal-sftp" ssh-ed25519 AAAA... msk-prodЕсли нужно, чтобы скомпрометированный прод не мог удалить старые снапшоты, используйте rest-server в режиме --append-only вместо голого SFTP. Чистку (forget --prune) тогда запускайте со стороны Франкфурта или с отдельной админской машины.
На московском VPS:
export RESTIC_REPOSITORY="sftp:backup@fra-backup:/srv/restic/msk"
export RESTIC_PASSWORD_FILE=/root/.restic-pass

pg_dump -Fc app > /var/backups/app.dump
restic backup /var/backups /var/www/uploads /etc/nginx --tag hourly
restic forget --keep-hourly 24 --keep-daily 14 --keep-weekly 8
rsync тоже имеет право на жизнь: например, для тёплого резерва, когда во Франкфурте нужна готовая к работе копия каталога загрузок, а не снапшот, который ещё надо распаковать:
rsync -aH --delete --bwlimit=20000 /var/www/uploads/ backup@fra-backup:/srv/warm/uploads/Осторожнее с --delete: зеркало повторит и случайное удаление на проде. Поэтому rsync-зеркало дополняет restic, а не заменяет его.
Про трафик. Первый полный бэкап может весить много, инкременты обычно небольшие. Но если вы гоняете гигабайты медиа каждый час, следите за месячным объёмом: на тарифах после 3 ТБ включается шейпинг до 1 Мбит/с, и тогда синхронизация застрянет как раз тогда, когда она нужнее всего. --bwlimit и разумная частота решают проблему.
Failover через DNS (TTL, pitfalls)
Самый доступный способ переключения — поменять A/AAAA-запись. Подробно про записи и делегирование есть в статье DNS на VPS: A, AAAA, TTL. Здесь — то, что важно именно для failover:
- TTL нужно снизить заранее. Если запись живёт с TTL 86400, резолверы будут помнить старый IP сутки, и никакое «быстрое переключение» не поможет. Для георезерва разумно держать 300–600 секунд постоянно, а не вспоминать об этом во время аварии.
- Не все уважают TTL. Часть резолверов и клиентов кэширует дольше. Закладывайте хвост трафика на старый адрес в течение нескольких часов.
- AAAA тоже переключайте. Классика: A уже смотрит во Франкфурт, а AAAA — всё ещё в мёртвую Москву, и клиенты с IPv6 продолжают ломиться в никуда.
- Сертификаты. Резервный сервер должен иметь валидный TLS-сертификат для домена заранее. HTTP-01 challenge не пройдёт, пока DNS смотрит на другой сервер, так что используйте DNS-01 или регулярно копируйте сертификаты в резерв.
- Где живёт DNS. Если авторитативные NS стоят на том же московском VPS, при аварии вы не сможете поменять запись. DNS-зона должна обслуживаться вне защищаемой площадки.
- Автоматика против флаппинга. Автоматический failover по health-check заманчив, но при моргании сети он может гонять трафик туда-сюда, а с двумя пишущими базами получить split-brain. Для небольших проектов честнее ручное переключение по алерту с понятным runbook.
Внешние проверки обеих локаций настраиваются так же, как в статье про мониторинг VPS: uptime, диск, CPU. Отдельно добавьте алерт на возраст последнего снапшота во Франкфурте: если бэкап не приезжал больше двух интервалов, это тоже авария, просто тихая.
152-ФЗ и данные в ЕС — осторожно
Этот раздел — не юридическая консультация, а предупреждение. Персональные данные граждан РФ — чувствительная тема с точки зрения места хранения: законодательство предъявляет требования к тому, где и как они хранятся и обрабатываются, а передача за рубеж, в том числе в ЕС, регулируется отдельно. Конкретные выводы зависят от того, какие данные вы обрабатываете, на каком основании и в какой роли выступаете.
Практически это означает:
- прежде чем копировать базу с пользователями во Франкфурт, обсудите схему с юристом;
- если требование хранить ПД в России к вам применимо, держите основной контур и резервы с ПД в РФ, а в ЕС отправляйте только то, что юрист признал допустимым (например, статику, код, конфигурацию без персональных данных);
- шифрование бэкапа — правильная техническая мера, но само по себе оно не отвечает на юридический вопрос о месте хранения.
Не принимайте решение «и так сойдёт» за юриста. Технически георезерв настраивается за вечер, а последствия неправильной схемы разгребаются гораздо дольше.
Учебное восстановление / drill
Георезерв, который ни разу не включали, — та же надежда, только в двух ДЦ. Раз в квартал (а после крупных изменений инфраструктуры — внепланово) проводите учения:
- Объявите окно и зафиксируйте время старта.
- Во Франкфурте восстановите последний снапшот:
restic restore latest --target /srv/drill, затемpg_restoreв отдельную базу. - Поднимите приложение на резервном VPS и проверьте его по hosts-файлу или тестовому поддомену, не трогая боевой DNS.
- Проверьте ключевые сценарии: логин, оформление заказа, загрузку файла, отправку писем.
- Запишите фактические RPO (возраст данных) и RTO (сколько заняло). Сравните с целевыми.
- Обновите runbook по тому, что пошло не так. Что-то всегда идёт не так: забытая переменная окружения, другая версия СУБД, закрытый порт в firewall.
Раз в год стоит провести полный drill с реальным переключением DNS в спокойное время и возвратом обратно в Москву. Это единственный способ проверить «обратное» направление. Похожий порядок действий пригодится и при плановом переезде проекта между площадками: по сути, это тот же failover, только без спешки.
Тарифы для георезерва
Для такой схемы нужны два VPS в разных локациях. Основной сервер можно взять в Москве — датацентр Нагатинский, резервный — в Германии, во Франкфурте. Бэкап-узлу обычно не нужен мощный CPU, важнее диск под репозиторий; тёплому резерву — примерно та же конфигурация, что у прода, иначе после переключения он просто не потянет нагрузку.
Тарифы — от 405 ₽, сервер выдаётся до 120 секунд после оплаты, поддержка работает 24/7. Учитывайте лимит трафика: после 3 ТБ в месяц скорость ограничивается до 1 Мбит/с, поэтому межДЦ-синхронизацию планируйте с запасом.
FAQ
Обязательно ли держать во Франкфурте запущенный сервер, или хватит хранилища бэкапов? Зависит от RTO. Если допустимы часы простоя, хватит репозитория restic и готового runbook. Если нужно подняться за минуты, держите тёплый резерв с установленным стеком.
Какой TTL ставить для записи, которую будем переключать? Обычно 300–600 секунд. Слишком маленький TTL увеличивает нагрузку на DNS и не всегда соблюдается резолверами; слишком большой делает переключение бессмысленно медленным. Главное — выставить его заранее, а не во время аварии.
Можно ли сделать обе площадки активными одновременно? Можно, но это уже другая сложность: репликация базы в обе стороны, конфликты записи, сессии. Для большинства небольших проектов схема active–passive надёжнее и дешевле в поддержке.
Можно ли хранить бэкап базы с пользователями во Франкфурте? Это вопрос не технический, а юридический. Персональные данные россиян чувствительны к хранению за рубежом; проконсультируйтесь с юристом и, если требуется, держите ПД в РФ.
Как часто проверять восстановление из второго ДЦ? Учебное восстановление без переключения DNS — раз в квартал, полный drill с переключением и возвратом — хотя бы раз в год и после крупных изменений инфраструктуры.