Мониторинг VPS без зоопарка: uptime, диск и CPU
Мониторинг VPS без зоопарка: uptime, диск и CPU
Узнать о падении от клиента — самый дорогой алерт. Он приходит уже после потери заказов, репутации и спокойного сна. На VPS достаточно небольшого набора проверок: внешний uptime, место на диске, load/CPU steal, память и доступность SSH — чтобы узнать о проблеме раньше пользователя. Ниже — практичная схема без Prometheus-фермы на одном сайте и без «двадцати дашбордов, которые никто не смотрит».
Если сервер уже «тупит», а не лежит, сначала разберите симптомы по диагностике тормозов VPS. Эта статья — про то, как не доводить до ночного звонка: что мерить, куда слать алерты и как не утонуть в шуме.
Внешний uptime и внутренние метрики — две разные задачи
Внешний мониторинг отвечает на вопрос: «сайт/порт доступны с интернета?». Внутренний — «хватит ли ресурсов и не разваливается ли ОС изнутри». Путать их дорого: HTTP 200 снаружи при диске 99% внутри — типичная ловушка перед падением БД в read-only.
Минимальный внешний контур:
- HTTP(S) на главный URL и health-check (
/health,/readyили статику); - TCP на критичные порты (443, иногда 22 с whitelista);
- DNS-резолв вашего домена (отдельный чек: A-запись «уехала» — сайт «упал» при живом VPS);
- интервал 1–5 минут, таймаут 5–10 секунд, порог «down» после 2–3 подряд неудач.
Делать внешний чек можно своим cron с другого VPS, Uptime Kuma, Healthchecks.io или встроенным пингом у регистратора. Главное — другой хост и другая сеть, иначе при падении датацентра вы не узнаете ничего. Для продакшена заведите отдельный маленький VPS под наблюдателя или используйте внешний SaaS; не крутите «самопинг» на той же машине, которую мониторите.
Внутренний контур смотрит ОС:
dfпо блокам и inode;- load average и CPU steal;
- свободная RAM и swap;
- доступность ключевых процессов (nginx, php-fpm, docker, postgres);
- свежесть бэкапа и cron’ов (отдельная тема, но алерт «бэкап старше 36 часов» спасает чаще, чем красивый график CPU).
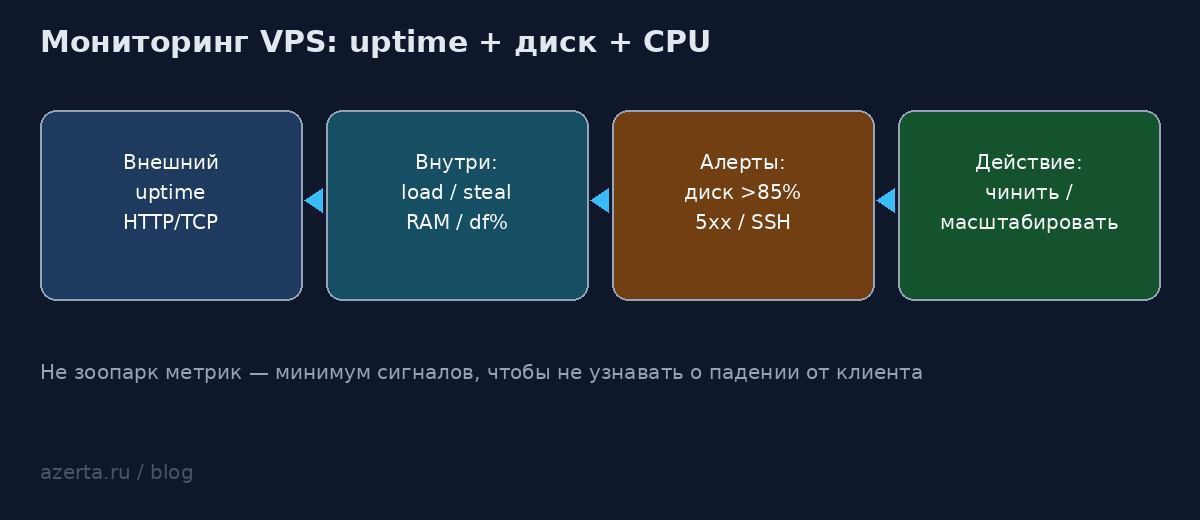
Связка простая: внешний алерт говорит «лежит или недоступен», внутренний — «скоро упадёт» или «тормозит». Оба нужны; один без другого оставляет слепую зону.
Что смотреть внутри: load, steal, RAM, df% и inode
Load average и steal
Load — очередь runnable-задач. На 1 vCPU load 4 уже тревожный; на 4 vCPU load 1.5 обычно норма. Смотрите в контексте числа ядер:
nproc
uptime
cat /proc/loadavg
На виртуализации важнее steal (%st в top/mpstat): это время, когда гипервизор отдал CPU соседям. Steal стабильно >10–15% на пиках — сигнал перегруженного гипервизора или слишком «тонкого» тарифа под ваш профиль. Тогда апгрейд vCPU или смена площадки полезнее, чем тюнинг PHP.
mpstat -P ALL 1 5
# колонка %steal / %st
vmstat 1 5
Если load высокий, а %us/%sy низкие и растёт %wa (iowait) — узкое место диск, не «мало ядер». Это как раз граница со статьёй про тормоза VPS: мониторинг ловит симптом, диагностика ищет причину.
RAM и swap
free -h
swapon --show
Алерт полезен не на «RAM 80%» (Linux любит кэш), а на:
- доступную память (
availableвfree) ниже порога, например <10–15% от объёма; - активный thrashing:
si/soвvmstatненулевые постоянно; - OOM в
dmesg/journalctl -k.
journalctl -k -b | grep -i -E 'out of memory|oom-killer' | tailКраткий всплеск swap при деплое — не катастрофа. Постоянный swap под нагрузкой — деградация latency задолго до «полного падения».
Диск: блоки и inode
df -hT | grep -v tmpfs
df -i | grep -v tmpfs
Порог 85% по блокам — разумный ранний алерт: ещё есть время чистить логи и journal, а не тушить 100% ночью. Отдельно мониторьте inode: PHP-сессии, кэш картинок и mail queue часто убивают раздел при «свободных» гигабайтах. Разбор «кто съел место» — в статье про диск 100%.
Если раздел систематически упирается в объём или IOPS (высокий iowait при нормальном CPU), сравните тарифы с большим NVMe на azerta.ru/vps/nvme — апгрейд диска дешевле, чем ночные prune и потерянные заказы.
Cron-скрипт или агент: без зоопарка стеков
На одном-двух VPS часто хватает shell + cron + Telegram/email. На флоте из десятка машин удобнее node_exporter + Prometheus или Netdata — но это не обязательный старт. Не продавайте себе стек ради стека: сначала закройте диск, SSH и HTTP.
Минимальный скрипт на bash
#!/bin/bash
# /usr/local/bin/vps-health.sh
set -euo pipefail

HOST="$(hostname -f 2>/dev/null || hostname)"
THRESH_DISK=85
THRESH_INODE=85
THRESH_LOAD_PER_CPU=2.0
ALERT_URL="${ALERT_WEBHOOK:-}"  # Telegram bot / Mattermost / свой endpoint

ncpu=$(nproc)
load=$(cut -d' ' -f1 /proc/loadavg)
# load / ncpu через awk
load_ratio=$(awk -v l="$load" -v n="$ncpu" 'BEGIN{printf "%.2f", l/n}')

disk_use=$(df -P / | awk 'NR==2 {gsub(/%/,""); print $5}')
inode_use=$(df -Pi / | awk 'NR==2 {gsub(/%/,""); print $5}')

msgs=()
[ "$disk_use" -ge "$THRESH_DISK" ] && msgs+=("disk/=${disk_use}%")
[ "$inode_use" -ge "$THRESH_INODE" ] && msgs+=("inode/=${inode_use}%")
awk -v r="$load_ratio" -v t="$THRESH_LOAD_PER_CPU" 'BEGIN{exit !(r>=t)}' \
  && msgs+=("load_per_cpu=${load_ratio} (load=${load}, ncpu=${ncpu})")

# SSH сам по себе не проверить изнутри надёжно; снаружи — отдельный чек.
# Здесь — наличие sshd:
if ! pgrep -x sshd >/dev/null 2>&1; then
  msgs+=("sshd_not_running")
fi

if [ "${#msgs[@]}" -eq 0 ]; then
  exit 0
fi

text="ALERT ${HOST}: ${msgs[*]}"
echo "$text" >&2

if [ -n "$ALERT_URL" ]; then
  curl -fsS -X POST -H 'Content-Type: application/json' \
    -d "{\"text\":\"$text\"}" "$ALERT_URL" >/dev/null || true
else
  # fallback: local mail if configured
  echo "$text" | mail -s "VPS alert $HOST" root 2>/dev/null || true
fi*/5 * * * * ALERT_WEBHOOK='https://example.com/hook' /usr/local/bin/vps-health.shПрава: chmod 750, владелец root. Webhook URL — в environment файла cron или в /etc/default/vps-health, не в git-репозитории сайта.
Netdata и node_exporter — когда уместны
- Netdata — быстрый «живой» дашборд на самой машине, мало конфигов, удобно глазами поймать steal/iowait. Минус: ещё один сервис и диск под историю, если хранить долго.
- node_exporter + Prometheus + Alertmanager — если уже есть стек или серверов больше трёх-пяти. Минус: сопровождение, retention, правила алертинга.
- Uptime Kuma / внешний HTTP — закрывает «лежит снаружи», не заменяет
dfи steal.
Выбирайте один путь и доведите до рабочих алертов. Зоопарк «и Netdata, и Zabbix, и три Telegram-бота» обычно значит, что ни один порог не откалиброван.
Проверка с рабочей станции, что снаружи всё живо (и что SSH доступен):
curl -fsS -o /dev/null -w '%{http_code} %{time_total}\n' https://example.com/health
nc -vz your.vps.ip 22
nc -vz your.vps.ip 443
Алерты, которые реально стоят ночного пробуждения
Не всё достойно сирены. Три класса, без которых нельзя:
1. Диск > 85% (и inode > 85%)
Ранний порог даёт время на journal vacuum, logrotate и Docker prune — пока сервисы ещё пишут. На 100% вы уже в сценарии «диск 100%: логи, Docker, journal». Отдельный алерт на /var или /var/lib/docker, если они на другом mount.
2. 5xx на критичном URL
Внешний чек должен уметь алертить не только на timeout, но и на HTTP ≥500 (иногда и на неожиданный 3xx/4xx для API). Внутренне полезен счётчик 5xx в access-логе nginx за окно 5 минут:
# эскиз: число 5xx за последние ~N строк лога
awk '$9 ~ /^5/ {c++} END{print c+0}' /var/log/nginx/access.log | tail
Для продакшена лучше fail2ban-независимый парсер или метрика из Exporter’а; идея та же — всплеск 5xx = деградация приложения при «зелёном» ping.
3. SSH down / sshd мёртв
Потеря SSH при живом HTTP — редкость, но при живом SSH и мёртвом HTTP вы хотя бы зайдёте чинить. Внешний TCP-чек порта 22 (с ограничением IP, если порт закрыт для мира) плюс внутренний pgrep sshd. Если SSH торчит в интернет — усильте вход по ключу и fail2ban в гайде по Ubuntu; мониторинг не заменяет hardening.
Дополнительно по вкусу: сертификат Let’s Encrypt истекает через <14 дней, очередь почты растёт, бэкап старше суток, Docker daemon не отвечает. Но начните с диска, 5xx и доступности — остальное наращивайте после калибровки шума.
Как не утонуть в шуме алертов
Плохой мониторинг хуже отсутствия: через неделю все пуши в mute, и снова узнаёте о падении от клиента.
Практичные правила:
- Один канал для «горит» (Telegram/SMS), другой для «посмотри днём» (email/чат). Не мешайте warning и critical.
- Дедуп и flatten: три проверки подряд failed → одно сообщение, не три. Восстановление — одно «recovered».
- Пороги с гистерезисом: алерт на 85%, снятие на 80% — иначе пила у границы.
- Тихие часы для warning, не для critical: диск 99% и SSH down будят всегда; load выше нормы на cron-окне — можно digests.
- Имя хоста и суть в первой строке:
ALERT shop-1: disk/=92%читается с телефона за секунду. - Раз в квартал ревизия: удалите алерты, на которые никогда не реагировали осмысленно.
Если за сутки пришло 40 сообщений и ни одно не привело к действию — пороги завышены по чувствительности. Поднимите интервал, увеличьте consecutive failures, сузьте список URL.
«Тормозит» и «лежит» — разные плейбуки
| Симптом | Что видит мониторинг | Куда идти |
|---|---|---|
| Timeout / connection refused снаружи | Внешний uptime red | Сеть, процесс слушает ли порт, firewall, крэш сервиса |
| HTTP 200, но TTFB 8–20 с | Uptime «зелёный», внутри load/iowait/steal | Диагностика тормозов |
| 5xx пачками | HTTP-check или лог | Приложение, БД, диск 100%, OOM |
| df → 100% | Внутренний disk alert | Диск 100% |
| Steal высокий | mpstat / агент | Соседи по гипервизору / апгрейд CPU |
Путать «тормозит» и «лежит» вредно: рестарт nginx не лечит iowait от умирающего диска, а расширение RAM не поднимет упавший sshd. Мониторинг должен классифицировать сигнал, а не только мигать красным.
Когда ресурсов стабильно не хватает (CPU steal, диск, RAM) и тюнинг исчерпан — смотрите каталог VPS: выдача обычно до 120 секунд после оплаты, тарифы от 360 ₽, поддержка 24/7. Площадки: датацентр в Москве (Нагатинский) и локация в Германии (без привязки к конкретному адресу в этом материале). Учтите лимит трафика: после 3 ТБ действует шейпинг до 1 Мбит/с — для тяжёлой раздачи медиа заложите это в capacity planning.
Связка: Ubuntu, безопасность и диск, который не доходит до 100%
Мониторинг хорошо ложится на уже приведённый в порядок сервер. Базовый контур Ubuntu (обновления, firewall, SSH-ключи, Docker без сюрпризов) — в настройке VPS на Ubuntu. Поверх него:
- Поставьте внешний HTTP/TCP чек на домен и SSH (по политике доступа).
- Добавьте cron
vps-health.shили агент с алертами на диск/inode/load. - Настройте logrotate и лимит journald до первого алерта на 85% — профилактика дешевле тушения.
- Документируйте playbook: «диск >85% → статья про 100%», «высокий iowait → статья про тормоза», «SSH down → консоль провайдера / KVM».
- Раз в месяц проверяйте, что webhook ещё жив: искусственно поднимите порог на тест или вызовите скрипт с
THRESH_DISK=0.
Подключение с Windows, macOS и Linux к серверу — в отдельном гайде «Подключиться по SSH»; без рабочего SSH и запасного канала (VNC/KVM в панели) алерт «sshd down» бесполезен.
Итоговый минимум на одном VPS занимает вечер: внешний uptime, скрипт на диск/load, три critical-алерта, выключенный шум. Этого достаточно, чтобы клиент перестал быть вашим самым дорогим датчиком.
FAQ
Нужен ли Prometheus на одном сайте-магазине? Обычно нет. Внешний uptime + cron на df/load + Telegram закрывают 90% рисков. Prometheus оправдан, когда серверов несколько или уже есть команда, которая поддерживает стек.
Почему uptime зелёный, а пользователи жалуются на тормоза? HTTP-check часто смотрит лёгкий URL и код 200. Медленная корзина, SSL или API на другом path не попадают в проверку. Добавьте check на критичный сценарий и смотрите внутренние метрики latency/iowait — см. VPS тормозит.
Какой порог диска ставить — 80, 85 или 90%? 85% — хороший старт для корня. На очень маленьких дисках (20–40 ГБ) имеет смысл 80%: от 85% до 100% логи Docker могут добить раздел за часы. На больших томах под медиа допустим 90%, если рост предсказуем.
Как мониторить SSH, если порт 22 закрыт снаружи? Внутренний pgrep sshd + проверка через VPN/bastion, либо TCP-чек с IP jump-хоста. Альтернатива — алерт панели провайдера на недоступность агента. Не открывайте 22 миру только ради мониторинга.
Netdata или node_exporter — что выбрать новичку? Если нужен быстрый обзор «что сейчас происходит» одной глазами — Netdata. Если планируете рост флота и единые правила Alertmanager — node_exporter. На старте достаточно bash-скрипта; агент добавите, когда упрётесь в его ограничения.
Что делать, если алерты идут, а места на диске хронически не хватает? Разово почистите по гайду про 100%, вынесите бэкапы и логи, затем оцените NVMe-тариф на /vps/nvme/. Постоянный prune без увеличения ёмкости — признак неверного размера диска под нагрузку, а не «плохого мониторинга».